객관식
데이터 수집
📦 이번 실습에서는 캐글(Kaggle)이라는 유명한 데이터 사이트에서 펭귄 데이터셋을 가져옵니다. 캐글은 전 세계 사람들이 데이터를 무료로 나누는 사이트예요.
직접 캐글에서 데이터를 찾아볼까요?
아래 링크로 캐글 데이터셋 페이지에 들어가서 직접 검색해볼 수 있어요.
① 검색창에 "penguins"를 검색해보세요
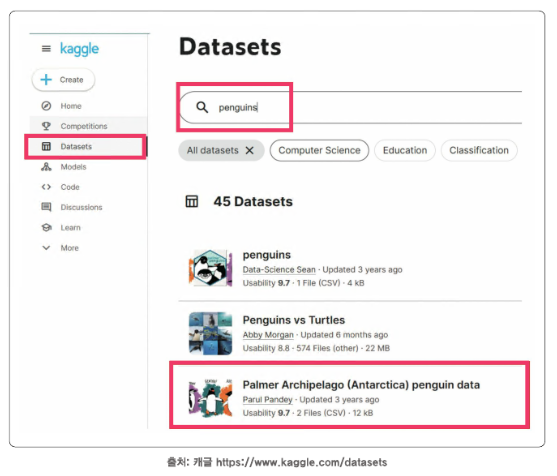
검색 결과 중 "Palmer Archipelago (Antarctica) penguin data"를 찾아 클릭하세요.
② penguins_size.csv 파일을 다운로드하세요
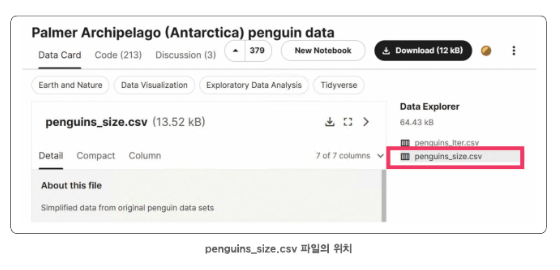
페이지에 들어가면 여러 파일이 보이는데, 그중 penguins_size.csv(7개 칼럼짜리 파일)를 다운로드하면 됩니다.
가져온 데이터에는 펭귄 344마리에 대한 7개의 정보(칼럼)가 들어 있어요.
| 칼럼명 | 의미 |
|---|---|
| species | 펭귄 종류 (턱끈/젠투/아델리) |
| island | 사는 섬 이름 |
| culmen_length_mm | 부리의 길이 |
| culmen_depth_mm | 부리의 깊이 |
| flipper_length_mm | 날개(지느러미)의 길이 |
| body_mass_g | 몸무게 |
| sex | 성별 |
어떤 게 종속변수이고, 어떤 게 독립변수일까?
우리가 맞히고 싶은 것이 종속변수, 그걸 맞히기 위해 참고하는 나머지 정보들이 독립변수예요. 재미있게도, 우리가 무엇을 맞히고 싶은지에 따라 같은 칼럼이라도 역할이 달라져요.
| 펭귄 종류를 맞히고 싶을 때 (분류) | 몸무게를 맞히고 싶을 때 (회귀) | |
|---|---|---|
| species (펭귄 종류) | 🎯 종속변수 (맞힐 것) | 독립변수 (참고 정보) |
| body_mass_g (몸무게) | 독립변수 (참고 정보) | 🎯 종속변수 (맞힐 것) |
배운 내용 확인하기
Q4-1. 펭귄의 "종류"를 맞히는 분류 문제를 만들 때, 종속변수(맞힐 대상)는 무엇일까요?